2026年 | プレスリリース・研究成果
音声に合わせて自然に動く3DデジタルヒューマンAIを開発 ― 表情・手指・全身動作をなめらかに生成、姿勢や動作も柔軟 ―
【本学研究者情報】
〇電気通信研究所 教授 北村喜文
研究室ウェブサイト
【発表のポイント】
- 分身のアバタやキャラクタ等のデジタルヒューマンの顔の表情、手指、全身の3D動作を音声発話から一体的に生成し、長い発話でも動きをなめらかにつなぐAI「DynaConTalk」(東北大が命名)を開発しました。
- 人の動きを、ゆっくりした姿勢変化、身振り、素早い手指・表情の動きに分けて学習するとともに、話すリズム、声の特徴、言葉の情報を場面ごとに使い分けることで、画一的な身振りや不自然な揺れを抑えました。
- 一般の人を含む30名が映像を見比べた評価では、生成したデジタルヒューマンの動きが、従来の技術よりも自然で、話の内容や声のタイミングに合っていると評価されました。学習済みの一つのモデルに、姿勢を変更したり参考となる動作を与えたりすることで、長時間の多様な動作を柔軟に生成することができます。
【概要】
デジタルヒューマンの活用が進む中、より豊かで自然な動作をもっと手軽に表現したいというニーズが高まっています。
こうした中、東北大学電気通信研究所の朱 逸飛 大学院生と香港大学の幸村 琢 教授らによる共同研究グループは、音声から表情・手指・全身の動きを長時間生成し、姿勢や参考動作で制御できるAI「DynaConTalk(ダイナコントーク)」を開発しました。動きを速さごとに分けて学習し、発話のリズム、声、言葉の情報を動的に使い分け、単調な身振りや不自然な揺れを抑えました。
AI分野で注目される最新の公開データセット「BEAT2」と「SHOW」で、生成動作と実際の動作の分布の近さを測る指標FGD(フレシェ開始距離)(注1)を、従来の最良値からそれぞれ約51%、約29%低減しました。30名による評価でも、自然さ、発話内容との一致、同期性、多様性で最も高い平均評価を得ました。
本研究成果は、2026年11月9日に出版されたACM Transactions on Graphicsに掲載され、12月1日~4日にマレーシア・クアラルンプールで開催されるCGとインタラクティブ技術の国際会議・展示会SIGGRAPH Asia 2026のTechnical Papersで発表する予定です。
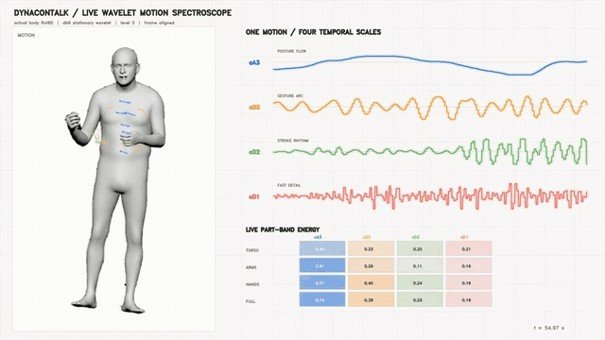
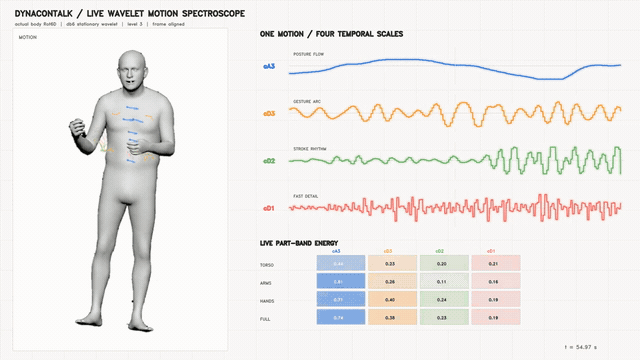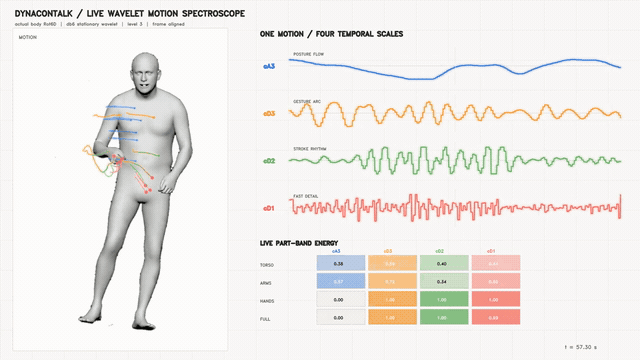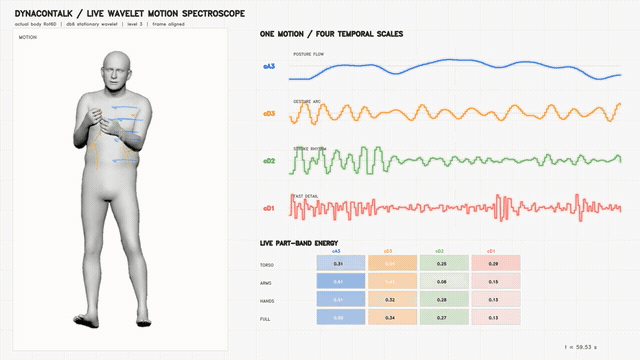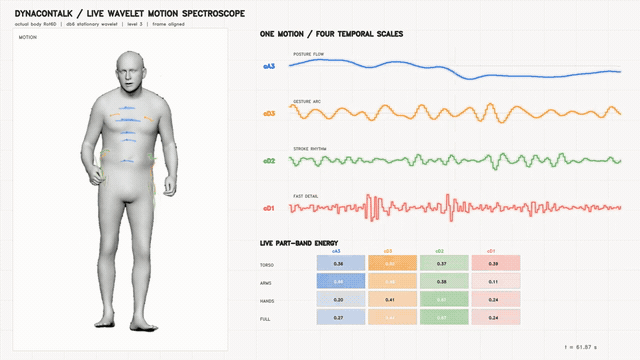
図1. 生成動作のウェーブレット分解の例。左は3Dデジタルヒューマンの動作、右上は低速から高速までの4つの時間周波数成分(姿勢・身振り・ストローク・細部)、右下は部位ごとの帯域エネルギーを示す。GIF動画:https://www.cr-ict.riec.tohoku.ac.jp/wp-content/uploads/2026/11/DynaConTalkPRfig1_wavelet.gif
【用語解説】
注1. FGD(Fréchet Gesture Distance):生成動作と実際の動作の特徴分布の距離を測る指標。値が小さいほど、生成動作全体の分布が実際の動作に近いことを示す。
【論文情報】
タイトル: DynaConTalk: Wavelet-Constrained Diffusion for Long-Form and Controllable Holistic Co-Speech 3D Motion
著者: Yifei Zhu*, Yangyang Cai, Mingyi Shi, Miao Cheng, Lin Gu, Taku Komura, Yoshifumi Kitamura
*責任著者: 東北大学 電気通信研究所 博士課程学生 朱 逸飛(Yifei Zhu)
掲載誌: ACM Transactions on Graphics, Vol. 45, No. 6, Article 194
DOI: 10.1145/3842553

問い合わせ先
(研究に関すること)
東北大学 電気通信研究所 インタラクティブコンテンツ研究室
博士課程学生 朱 逸飛(Yifei Zhu)
Email: zhuyifei.q4*dc.tohoku.ac.jp(*を@に置き換えてください)
教授 北村 喜文(Yoshifumi Kitamura)
Email: kitamura*riec.tohoku.ac.jp(*を@に置き換えてください)
TEL:022--217--5540
(報道に関すること)
東北大学 電気通信研究所 広報室
TEL: 022--217--5427
Email:riec-kohoshitsu*grp.tohoku.ac.jp(*を@に置き換えてください)